En ligne ou sur site, les formations live en présentiel à Apache Spark, animées par un instructeur, illustrent par la pratique comment Spark s'intègre à l'écosystème Big Data et comment l'utiliser pour l'analyse de données.
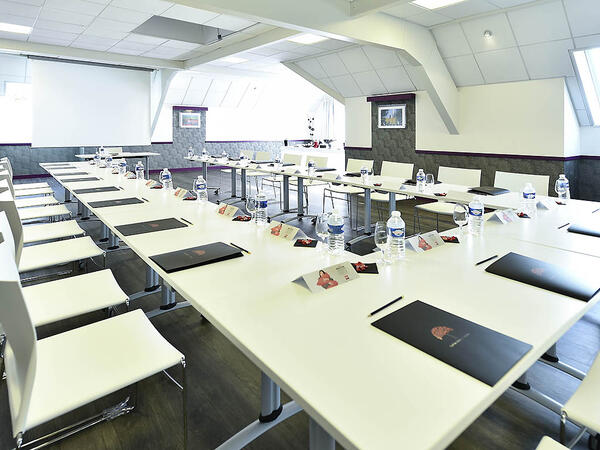
La formation Apache Spark est disponible en mode « formation live en ligne » ou « formation live sur site ». La formation live en ligne (également appelée « formation live à distance ») est réalisée via un bureau à distance interactif. La formation live sur site peut être dispensée localement dans les locaux du client à Lyon ou dans les centres de formation de NobleProg à Lyon.
NobleProg -- Votre prestataire de formation local
Lyon, Gare Lyon Part-Dieu
NobleProg Lyon, 10 Place Charles Béraudier, Lyon, france, 69000
Situé à 200 mètres de la gare TGV, la Tour Suisse est l'immeuble de bureaux le plus emblématique de ce secteur de Lyon. Le centre d'affaires vous propose un lieu de qualité pour vos formations, séminaires et réunions.
Gares TGV
Gare TGV Part-Dieu à 100 mètres, sortie porte du Rhône
Aéroport
Lyon Saint Exupéry (Satolas) à 30 minutes
Rhône Express depuis l’aéroport Saint Exupéry
Ce formation en direct (en ligne ou sur site) est destinée aux scientifiques des données et ingénieurs de niveau intermédiaire qui souhaitent utiliser Google Colab et Apache Spark pour le traitement et l'analyse de grandes masses de données.
À la fin de cette formation, les participants seront capables de :
Configurer un environnement big data en utilisant Google Colab et Spark.
Traiter et analyser des jeux de données volumineux efficacement avec Apache Spark.
Visualiser les grands ensembles de données dans un environnement collaboratif.
Intégrer Apache Spark avec des outils basés sur le cloud.
Cette formation en direct, animée par un formateur sur Lyon, couvre la plateforme Stratio, en mettant l'accent sur les modules Rocket et Intelligence avec PySpark. Les participants maîtriseront l'ingestion, la transformation et l'analyse avancée des données, acquérant des compétences pratiques dans les boucles, les UDF et les flux de données d'entreprise.
Cette formation en Lyon (en ligne ou sur site) est destinée aux développeurs qui souhaitent utiliser et intégrer Spark, Hadoop et Python pour traiter, analyser et transformer des ensembles de données complexes et volumineux.
A l'issue de cette formation, les participants seront capables de :
Mettre en place l'environnement nécessaire pour commencer à traiter les big data avec Spark, Hadoop et Python.
Comprendre les fonctionnalités, les composants de base et l'architecture de Spark et Hadoop.
Apprendre à intégrer Spark, Hadoop et Python pour le traitement des big data.
Explorer les outils de l'écosystème Spark (Spark MlLib, Spark Streaming, Kafka, Sqoop, Kafka et Flume).
Construire des systèmes de recommandation par filtrage collaboratif similaires à Netflix, YouTube, Amazon, Spotify et Google.
Utiliser Apache Mahout pour mettre à l'échelle des algorithmes d'apprentissage automatique.
Cette formation en direct, animée par un formateur, sur Lyon (en ligne ou sur site), s'adresse aux administrateurs système de niveau débutant à intermédiaire souhaitant déployer, maintenir et optimiser des clusters Spark.
À l'issue de cette formation, les participants seront capables de :
Installer et configurer Apache Spark dans divers environnements.
Gérer les ressources du cluster et surveiller les applications Spark.
Optimiser les performances des clusters Spark.
Mettre en œuvre des mesures de sécurité et garantir une haute disponibilité.
Diagnostiquer et résoudre les problèmes courants liés à Spark.
Dans cette formation en direct animée par un instructeur à Lyon, les participants apprendront comment utiliser conjointement Python et Spark pour analyser le Big Data, en s'appuyant sur des exercices pratiques.
À l'issue de cette formation, les participants seront en mesure de :
Apprendre à utiliser Spark avec Python pour analyser le Big Data.
Réaliser des exercices qui reproduisent des cas réels.
Utiliser différents outils et techniques pour l'analyse du Big Data au moyen de PySpark.
Ce formation en présentiel (en ligne ou sur site) s'adresse aux ingénieurs des données, analystes de données et professionnels des données souhaitant utiliser Databricks et PySpark pour créer des pipelines de données évolutifs et migrer leurs workflows SQL existants.
Cette formation offre une introduction pratique à la construction de workflows évolutifs de traitement de données et de Machine Learning utilisant PySpark. Les participants découvrent le fonctionnement d'Apache Spark au sein des écosystèmes modernes de Big Data et apprennent à traiter efficacement de grands volumes de données grâce aux principes du calcul distribué.
Ce cours pratique de trois jours se concentre sur la conception et l'optimisation de charges de travail de traitement de données efficaces à l'aide de PySpark, Pandas et Polars dans des environnements basés sur Kubernetes.
Les participants développeront une compréhension pratique de l'exécution des applications Spark sur Kubernetes et de la manière dont les décisions de configuration au niveau applicatif influencent les performances, la scalabilité, la consommation de ressources et les coûts. Le cours couvre des domaines clés d'optimisation, notamment la taille des exécuteurs, l'allocation de la mémoire, l'allocation dynamique, les stratégies de partitionnement, le comportement du shuffle, les problèmes de petits fichiers et le traitement efficace de Parquet.
Le cours aborde également les défis courants liés à l'utilisation de Pandas, tels que les limitations de mémoire et les erreurs de dépassement de mémoire, et introduit Polars comme alternative haute performance pour certaines charges de travail de traitement de données. À travers des exercices pratiques, les participants diagnostiqueront les problèmes de performance et de mémoire, compareront différentes stratégies de configuration et appliqueront des techniques d'optimisation à des scénarios réalistes d'ETL et d'apprentissage automatique.
La priorité tout au long du cours est donnée à la prise de décision pratique : comprendre comment identifier les goulets d'étranglement, sélectionner l'outil approprié, configurer Spark efficacement et trouver l'équilibre entre les performances et la consommation de ressources d'infrastructure et les coûts.
Cette formation en direct (en ligne ou sur site) s'adresse aux ingénieurs qui souhaitent mettre en place et déployer un système Apache Spark de traitement de très grandes quantités de données.
A l'issue de cette formation, les participants seront capables de :
Installer et configurer Apache Spark.
Traiter et analyser rapidement de très grands ensembles de données.
Comprendre la différence entre Apache Spark et Hadoop MapReduce et savoir quand utiliser l'un ou l'autre.
Intégrer Apache Spark avec d'autres outils d'apprentissage automatique.
Cette formation pratique dans Lyon démystifie Apache Spark en couvrant les RDD, les DataFrames et les API Python/Scala. Les participants maîtriseront le déploiement cloud avec Databricks, AWS EMR et Glue, développant ainsi des compétences pratiques pour des tâches réelles d'ingénierie des données et de DevOps.
En savoir plus...
Dernière Mise À Jour:
Nos clients témoignent (4)
Un voyage à travers l'univers de Spark : un cours très intensif. DSL, Spark SQL, partitionnement versus bucketing pour moi.
Georgiana Elisabeta
Formation - Apache Spark Fundamentals
Traduction automatique
J'ai aimé qu'il soit pratique. J'ai adoré appliquer les connaissances théoriques avec des exemples pratiques.
Aurelia-Adriana - Allianz Services Romania
Formation - Python and Spark for Big Data (PySpark)
Traduction automatique
Le fait que nous ayons pu emporter avec nous la plupart des informations/cours/présentations/exercices effectués, afin de pouvoir les revoir et éventuellement refaire ce que nous n'avions pas compris la première fois ou améliorer ce que nous avions déjà fait.
Raul Mihail Rat - Accenture Industrial SS
Formation - Python, Spark, and Hadoop for Big Data
Traduction automatique
Avoir des sessions pratiques / des devoirs
Poornima Chenthamarakshan - Intelligent Medical Objects
Apache Spark formation à Lyon, Weekend Spark cours à Lyon, Soir Apache Spark formation à Lyon, Spark formateur en ligne à Lyon, Spark formation à Lyon, Apache Spark cours du soir à Lyon, Apache Spark formation Intra à Lyon, Spark formation Intra Entreprise à Lyon, Apache Spark formation Inter à Lyon, Apache Spark formation Inter Entreprise à Lyon, Spark professeur à Lyon,Apache Spark cours à Lyon, Weekend Spark formation à Lyon, Apache Spark coaching à Lyon, Spark préparation à Lyon, Apache Spark instructeur à Lyon, Apache Spark stage de préparation à Lyon, Soir Apache Spark cours à Lyon, Apache Spark entraînement à Lyon, Apache Spark cours particuliers à Lyon, Apache Spark sur place à Lyon, Apache Spark coach à Lyon, Apache Spark préparation aux examens à Lyon, Spark cours privé à Lyon, Spark formateur à Lyon